爬虫社区网络爬虫技术
爬虫社区 时间:2021-05-27 阅读:()
请问什么是网络爬虫啊?是干什么的呢?
网络爬虫(Web crawler)是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。网络爬虫被广泛用于互联网搜索引擎或其他类似网站,可以自动采集所有其能够访问到的页面内容,以获取或更新这些网站的内容和检索方式。
扩展资料: 许多网站针对爬虫都设置了反爬虫机制。
常见的有: 1、登陆限制:通过模拟登陆可以解决 2、用户代理检测:通过设置User-Agent header 3、Referer检测:通过设置Referer header 4、访问频率限制:如果是针对同一账号的频率限制,则可以使用多个账号轮流发请求;如果针对IP,可通过IP代理;还可以为相邻的两个请求设置合适的时间间隔来,减小请求频率,从而避免被服务端认定为爬虫。
参考资料:网络爬虫搜狗百科
爬虫是神马??
又称网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者。是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。
另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。
分为以下几种类型:通用网络爬虫、聚焦网络爬虫、增量式网络爬虫、深层网络爬虫。
实际的网络爬虫系统通常是几种爬虫技术相结合实现的
开源爬虫框架各有什么优缺点?
首先爬虫框架有三种 1. 分布式爬虫:Nutch 2. JAVA单机爬虫:Crawler4j,WebMagic,WebCollector 3. 非JAVA单机爬虫:scrapy 第一类:分布式爬虫 优点: 1. 海量URL管理 2. 网速快 缺点: 1. Nutch是为搜索引擎设计的爬虫,大多数用户是需要一个做精准数据爬取(精抽取)的爬虫。Nutch运行的一套流程里,有三分之二是为了搜索引擎而设计的。
对精抽取没有太大的意义。
2. 用Nutch做数据抽取,会浪费很多的时间在不必要的计算上。
而且如果你试图通过对Nutch进行二次开发,来使得它适用于精抽取的业务,基本上就要破坏Nutch的框架,把Nutch改的面目全非。
3. Nutch依赖hadoop运行,hadoop本身会消耗很多的时间。
如果集群机器数量较少,爬取速度反而不如单机爬虫。
4. Nutch虽然有一套插件机制,而且作为亮点宣传。
可以看到一些开源的Nutch插件,提供精抽取的功能。
但是开发过Nutch插件的人都知道,Nutch的插件系统有多蹩脚。
利用反射的机制来加载和调用插件,使得程序的编写和调试都变得异常困难,更别说在上面开发一套复杂的精抽取系统了。
5. Nutch并没有为精抽取提供相应的插件挂载点。
Nutch的插件有只有五六个挂载点,而这五六个挂载点都是为了搜索引擎服务的,并没有为精抽取提供挂载点。
大多数Nutch的精抽取插件,都是挂载在“页面解析”(parser)这个挂载点的,这个挂载点其实是为了解析链接(为后续爬取提供URL),以及为搜索引擎提供一些易抽取的网页信息(网页的meta信息、text) 6. 用Nutch进行爬虫的二次开发,爬虫的编写和调试所需的时间,往往是单机爬虫所需的十倍时间不止。
了解Nutch源码的学习成本很高,何况是要让一个团队的人都读懂Nutch源码。
调试过程中会出现除程序本身之外的各种问题(hadoop的问题、hbase的问题)。
7. Nutch2的版本目前并不适合开发。
官方现在稳定的Nutch版本是nutch2.2.1,但是这个版本绑定了gora-0.3。
Nutch2.3之前、Nutch2.2.1之后的一个版本,这个版本在官方的SVN中不断更新。
而且非常不稳定(一直在修改)。
第二类:JAVA单机爬虫 优点: 1. 支持多线程。
2. 支持代理。
3. 能过滤重复URL的。
4. 负责遍历网站和下载页面。
爬js生成的信息和网页信息抽取模块有关,往往需要通过模拟浏览器(htmlunit,selenium)来完成。
缺点: 设计模式对软件开发没有指导性作用。
用设计模式来设计爬虫,只会使得爬虫的设计更加臃肿。
第三类:非JAVA单机爬虫 优点: 1. 先说python爬虫,python可以用30行代码,完成JAVA? 2. 50行代码干的任务。
python写代码的确快,但是在调试代码的阶段,python代码的调试往往会耗费远远多于编码阶段省下的时间。
3. 使用python开发,要保证程序的正确性和稳定性,就需要写更多的测试模块。
当然如果爬取规模不大、爬取业务不复杂,使用scrapy这种爬虫也是蛮不错的,可以轻松完成爬取任务。
缺点: 1. bug较多,不稳定。
1. 爬虫可以爬取ajax信息么? 网页上有一些异步加载的数据,爬取这些数据有两种方法:使用模拟浏览器(问题1中描述过了),或者分析ajax的http请求,自己生成ajax请求的url,获取返回的数据。
如果是自己生成ajax请求,使用开源爬虫的意义在哪里?其实是要用开源爬虫的线程池和URL管理功能(比如断点爬取)。
2. 如果我已经可以生成我所需要的ajax请求(列表),如何用这些爬虫来对这些请求进行爬取? ? ? ? 爬虫往往都是设计成广度遍历或者深度遍历的模式,去遍历静态或者动态页面。
爬取ajax信息属于deepweb(深网)的范畴,虽然大多数爬虫都不直接支持。
但是也可以通过一些方法来完成。
比如WebCollector使用广度遍历来遍历网站。
爬虫的第一轮爬取就是爬取种子集合(seeds)中的所有url。
简单来说,就是将生成的ajax请求作为种子,放入爬虫。
用爬虫对这些种子,进行深度为1的广度遍历(默认就是广度遍历)。
3. 爬虫怎么爬取要登陆的网站? 这些开源爬虫都支持在爬取时指定cookies,模拟登陆主要是靠cookies。
至于cookies怎么获取,不是爬虫管的事情。
你可以手动获取、用http请求模拟登陆或者用模拟浏览器自动登陆获取cookie。
4. 爬虫怎么抽取网页的信息? 5. 开源爬虫一般都会集成网页抽取工具。
主要支持两种规范:CSSSELECTOR和XPATH。
6. 网页可以调用爬虫么? 爬虫的调用是在Web的服务端调用的,平时怎么用就怎么用,这些爬虫都可以使用。
7. 爬虫速度怎么样? 单机开源爬虫的速度,基本都可以讲本机的网速用到极限。
爬虫的速度慢,往往是因为用户把线程数开少了、网速慢,或者在数据持久化时,和数据库的交互速度慢。
而这些东西,往往都是用户的机器和二次开发的代码决定的。
这些开源爬虫的速度,都很可以。
网络爬虫技术
网络技术包含的方面太多了。有安全方面的,路由和交换方面的,服务器的管理和部署方面的,甚至像思科和华为的认证还有语音、存储、运营商方面的,也有像网络编程这一块的(网站设计),这些东西你不可能都学好的,选择一个方向慢慢学。
我建议你从路由和交换技术学起。
SunthyCloud阿里云国际版分销商注册教程,即可PayPal信用卡分销商服务器
阿里云国际版注册认证教程-免绑卡-免实名买服务器安全、便宜、可靠、良心,支持人民币充值,提供代理折扣简介SunthyCloud成立于2015年,是阿里云国际版正规战略级渠道商,也是阿里云国际版最大的分销商,专业为全球企业客户提供阿里云国际版开户注册、认证、充值等服务,通过SunthyCloud开通阿里云国际版只需要一个邮箱,不需要PayPal信用卡就可以帮你开通、充值、新购、续费阿里云国际版,服务...
pacificrack:VPS降价,SSD价格下降
之前几个月由于CHIA挖矿导致全球固态硬盘的价格疯涨,如今硬盘挖矿基本上已死,硬盘的价格基本上恢复到常规价位,所以,pacificrack决定对全系Cloud server进行价格调整,降幅较大,“如果您是老用户,请通过续费管理或升级套餐,获取同步到最新的定价”。官方网站:https://pacificrack.com支持PayPal、支付宝等方式付款VPS特征:基于KVM虚拟,纯SSD raid...
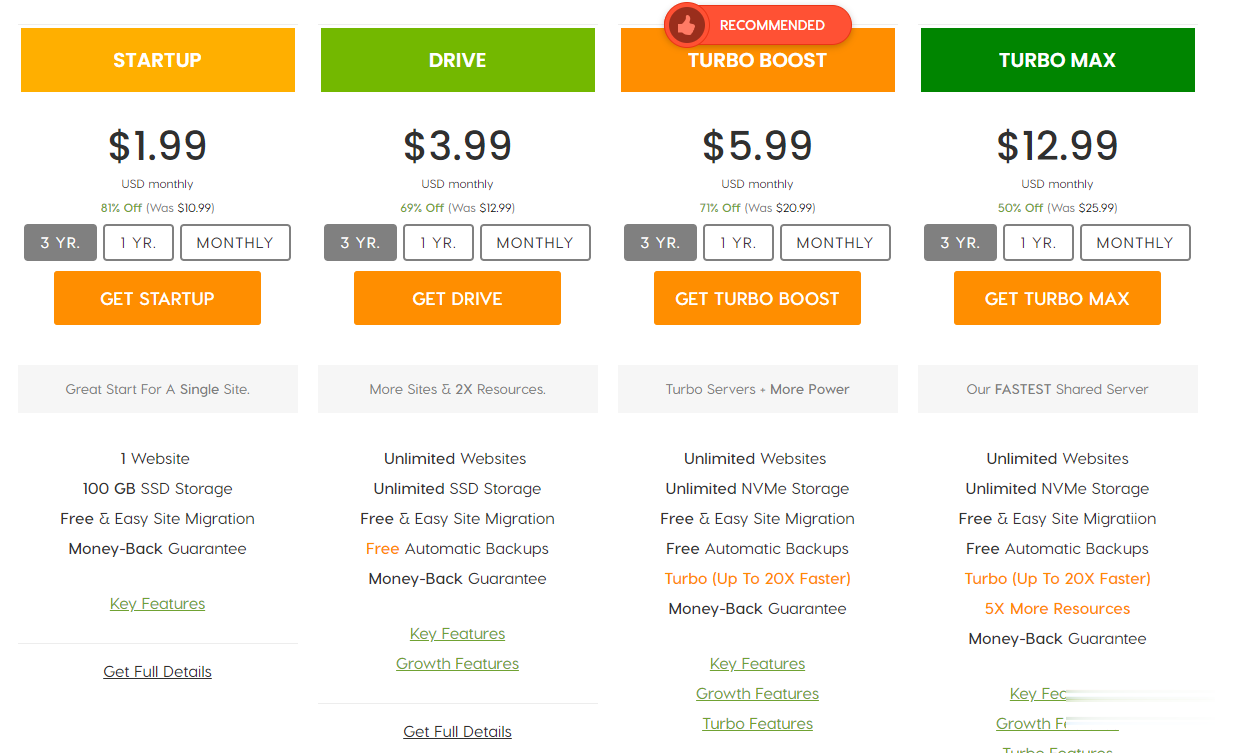
A2Hosting三年付$1.99/月,庆祝18周年/WordPress共享主机最高优惠81%/100GB SSD空间/无限流量
A2Hosting主机,A2Hosting怎么样?A2Hosting是UK2集团下属公司,成立于2003年的老牌国外主机商,产品包括虚拟主机、VPS和独立服务器等,数据中心提供包括美国、新加坡softlayer和荷兰三个地区机房。A2Hosting在国外是一家非常大非常有名气的终合型主机商,拥有几百万的客户,非常值得信赖,国外主机论坛对它家的虚拟主机评价非常不错,当前,A2Hosting主机庆祝1...
爬虫社区为你推荐
-
国内免备案yosyun形容yo快的成语查看硬盘大小怎样查看自己电脑硬盘大小好看的表格样式创意如何使用PS快速制作美观的表格好看的表格样式创意怎么设计漂亮的excel 表格云主机能玩游戏吗客厅云电脑可以在电视上玩网页游戏吗?接收验证码接受验证码要短信费吗短信收费吗?好看的div样式三种不同类型的CSS样式商城域名中文.商城域名为什么有投资价值?阿里云服务器关闭防火墙阿里云linux能关闭防火墙吗虚拟主机出售做一个卖虚拟主机的网站要花多少钱!