抓取百度蜘蛛的工作原理
百度蜘蛛是一个程序其工作原理
第一搜索引擎构建一个调度程序来调度百度蜘蛛的工作蜘蛛在访问网站页面时类似与普通访客浏览让百度蜘蛛去和服务器建立连接下载网页计算的过程都是通过调度来计算的百度蜘蛛抓页面的时候从起始站点即种子站点指的是一些门户站点是广度优先抓取是为了抓取更多的网址深度优先抓取的目的是为了抓取高质量的网页这个策略是由调度来计算和分配的百度蜘蛛只负责抓取权重优先是指反向连接较多的页面的优先抓取这也是调度的一种策略百度蜘蛛只是负责下载网页 目前的搜索引擎普遍使用广布式多服务器多线程的百度蜘蛛来达到多线程的目的。理论上从一定范围地网页出发,就能搜集到绝大多数地网页。抓取顺序则是权重优先,门户类或者是反向连接较多的页面的优先抓取通过百度蜘蛛下载回来的网页放到补充数据区通过各种程序计算过后才放到检索区才会形成稳定的排名所以说只要下载回来的东西都可以通过指令找到补充数据是不稳定的有可能在各种计算的过程中给k掉检索区的数据排名是相对比较稳定的百度目前是缓存机制和补充数据相结合的正在向补充数据转变这也是目前百度收录困难的原因也是很多站点今天给k了明天又放出来的原因。一般情况下网页抓取抓到40%是正常范围 60%算很好 100%是不可能的 当然抓取的越多越好。
第二,抓取页面后的处理工作,搜索引擎抓到网页后还要做大量地预处理工作,最重要地就是提取关键词建立索引文件.其他还包括去除重复网页、分析超链接、计算网页地重要度。百度蜘蛛在从首页登陆后抓取首页后调度会计算其中所有的连接返回给百度蜘蛛进行下一步的抓取连接列表百度蜘蛛再进行下一步的抓取网址地图的作用是为了给百度蜘蛛提供一个抓取的方向来左右百度蜘蛛去抓取重要页面如何让百度蜘蛛知道那个页面是重要页面可以通过连接的构建来达到这个目的越多的页面指向该页 网址首页的指向副页面的指向等等都能提高该页的权重地图的另外一个作用是给百度蜘蛛提供更多的连接来达到抓去更多页面的目的地图其实就是一个连接的列表提供给百度蜘蛛来计算你的目录结构找到通过站内连接来构建的重要页面。
第三,提供检索工作,页面抓取处理完后,搜索引擎从索引数据库中找到匹配该关键词地网页;为了用户便于判断,除了网页标题和URL外 还会提供一段来自网页地摘要以及其他信息。检索工作完成后,用户在百度的搜索栏里就可以看到相关的信息.
文章由www.xiazhou2.c om www.xiazhou.net 整理上传转载请注明
- 抓取百度蜘蛛的工作原理相关文档
- 传媒百度蜘蛛
- 蜘蛛让百度蜘蛛经常访问网站的方法
- 网站实战:如何引诱百度蜘蛛?
- 您的百度蜘蛛异常爬网的原因
- 爬虫如何提高百度蜘蛛的爬行抓取频率时间(网络营销范文)
- 蜘蛛百度蜘蛛如何判断高质量的文章?(网站优化范文)
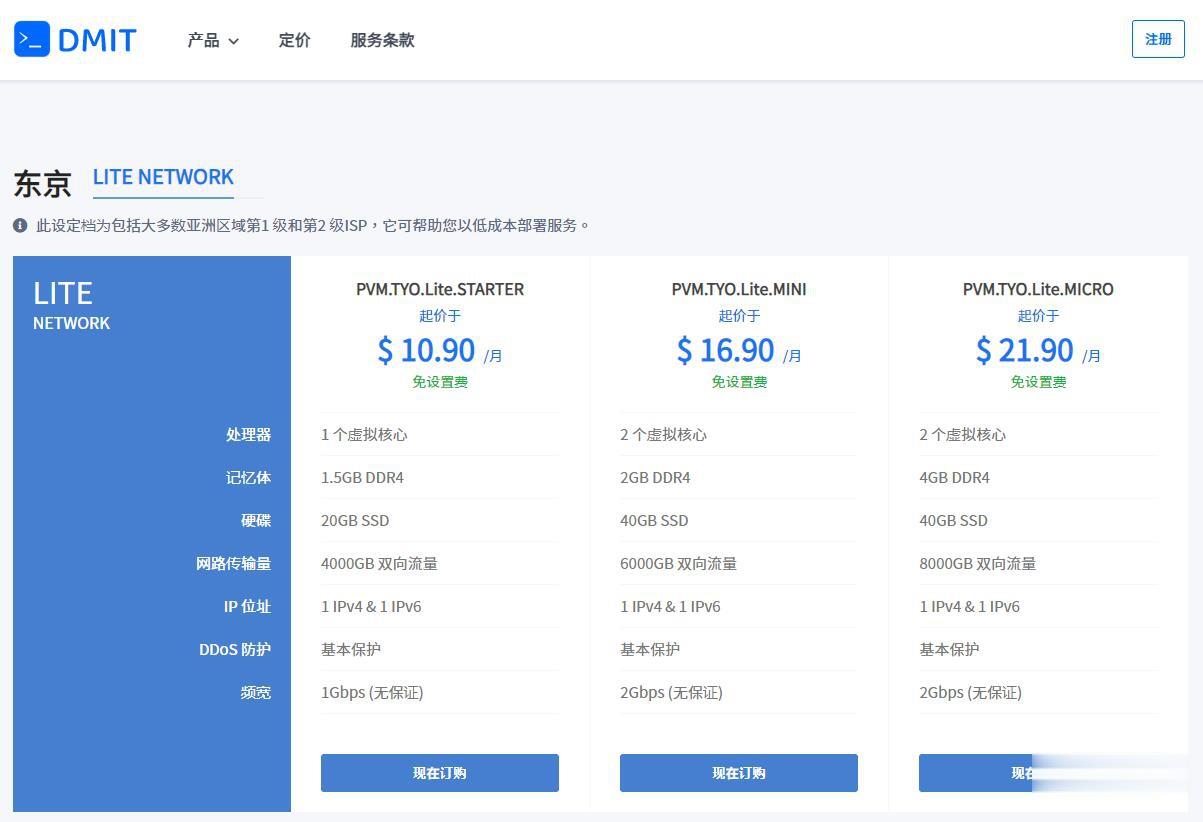
DMIT$10.9/月,日本VPS/三网直连/1核1.5G内存/20GB存储/1Gbps端口
优惠码年付一次性5折优惠码:TYO-Lite-Open-Beta-1y-50OFF永久8折优惠码:TYO-Lite-Open-Beta-Recur-20OFF日本vpsCPU内存SSD流量带宽价格购买1核1.5G20 GB4 TB1Gbps$10.9/月购买2核2 G40 GB6 TB1Gbps$16.9/月购买2核4 G60 GB8 TB1Gbps$21.9/月购买4核4 G80 GB12 TB...
digital-vm:VPS低至$4/月,服务器$80/月,10Gbps超大带宽,不限流量,机房可选:日本新加坡美国英国西班牙荷兰挪威丹麦
digital-vm,这家注册在罗马尼亚的公司在国内应该有不少人比较熟悉了,主要提供VPS业务,最高10Gbps带宽,还不限制流量,而且还有日本、新加坡、美国洛杉矶、英国、西班牙、荷兰、挪威、丹麦这些可选数据中心。2020年,digital-vm新增了“独立服务器”业务,暂时只限“日本”、“新加坡”机房,最高也是支持10Gbps带宽... 官方网站:https://digital-vm.co...
RFCHOST - 洛杉矶CN2 GIA VPS季付23.9美元起 100Mbps带宽
RFCHOST,这个服务商我们可能有一些朋友知道的。不要看官网是英文就以为是老外服务商,实际上这个服务商公司在上海。我们实际上看到的很多商家,有的是繁体,有的是英文,实际上很多都是我们国人朋友做的,有的甚至还做好几个品牌域名,实际上都是一个公司。对于RFCHOST商家还是第一次分享他们家的信息,公司成立大约2015年左右。目前RFCHOST洛杉矶机房VPS正进行优惠促销,采用CN2优化线路,电信双...
-
外挂购买外挂什么意思甲骨文不满赔偿劳动法员工工作不满一个月辞退赔偿标准百度关键词分析关键词怎么分析?抓站工具抓鸡要什么工具?www4399com4399网站是什么盗车飞侠侠盗飞车罪恶都市全部秘籍ps手柄版的鲁伽欣打什么工啊 ? 大家一起卖猪肉吧采采风荷我家种了几亩莲藕,听说不能采荷叶、荷花、莲蓬、否则莲藕会烂的?是真的吗?为什么?新广告法被投诉违反了新广告法该怎么办源代码源码是什么东西啊?哪位大神给我讲讲